Research Note
AI Identifikasi Suara: Integrasi Speaker Diarization, Verification, dan Speech-to-Text secara Real-Time
Pipeline real-time yang memadukan speaker diarization, speaker verification, dan speech-to-text, berjalan lokal di laptop CPU tanpa GPU, lengkap dengan kalibrasi threshold dan pelabelan pembicara tak terdaftar.
Abstrak
Dokumentasi percakapan otomatis (siapa berbicara, kapan, dan apa yang diucapkan) masih banyak bergantung pada layanan cloud berbayar yang tidak memiliki kemampuan bawaan mengenali identitas pembicara. Riset ini membangun dan menguji sistem yang memadukan tiga modul speaker diarization, speaker verification, dan speech-to-text dalam satu pipeline real-time yang berjalan sepenuhnya lokal di laptop CPU tanpa GPU, dilengkapi dashboard web (Flask) untuk pemantauan langsung. Sistem dikalibrasi menggunakan pendekatan threshold leave-one-out dan mekanisme keputusan berbasis margin untuk menekan kesalahan identifikasi, serta mekanisme pelabelan persisten (Unknown_N) untuk pembicara tak terdaftar. Hasil pengujian menunjukkan sistem mampu mengenali pembicara terdaftar dengan skor kemiripan konsisten (0.4–0.6) dan menolak suara asing yang sebelumnya salah dikenali. Namun ditemukan juga temuan negatif inkonsistensi pelabelan pembicara tak dikenal, berdasarkan tinjauan literatur, ternyata mencerminkan keterbatasan mendasar pendekatan threshold sederhana untuk masalah open-set speaker recognition yang memang masih menjadi area riset aktif.
**Catatan riset ini adalah publikasi internal AI Lab yang masih berjalan (ongoing), belum melalui peer review eksternal, dan dataset yang digunakan masih terbatas. Kami publikasikan untuk transparansi proses belajar tim.**
Latar Belakang & Tujuan
Dalam berbagai aktivitas kolaboratif seperti rapat tim, diskusi riset, atau kegiatan lapangan yang melibatkan banyak pembicara, dokumentasi percakapan masih banyak dilakukan secara manual baik lewat notulensi tertulis maupun perekaman audio yang harus ditranskrip ulang satu per satu. Dua permasalahan operasional utama yang rutin terjadi yang pertama, sulitnya melacak secara akurat siapa yang berbicara pada suatu momen tertentu ketika banyak orang bergantian bicara dalam satu sesi rekaman lalu yang kedua, proses transkripsi manual dari suara ke teks memakan waktu dan tenaga yang tidak sedikit. Solusi speech-to-text yang tersedia secara umum saat ini pun mayoritas berbasis layanan cloud berbayar, yang mengharuskan koneksi internet stabil dan biaya berlangganan, serta tidak memiliki kemampuan bawaan untuk mengenali identitas pembicara.
Riset ini bertujuan untuk membangun dan mengevaluasi sistem otomasi berbasis kecerdasan buatan yang memadukan speaker diarization untuk mendeteksi siapa yang berbicara dan kapan, speaker verification untuk mengidentifikasi pembicara, serta speech-to-text untuk mentranskripsikan ucapan ke dalam teks. Sistem dirancang untuk berjalan secara real-time menggunakan mikrofon laptop standar, sepenuhnya secara lokal tanpa GPU maupun layanan cloud eksternal, serta dilengkapi dashboard web untuk memudahkan pemantauan. Evaluasi sistem difokuskan pada kemampuan mengenali pembicara terdaftar menggunakan tingkat kepercayaan yang terkalibrasi, membedakan pembicara yang tidak terdaftar, serta memastikan seluruh proses dapat berjalan dengan latensi yang dapat diterima pada perangkat kelas konsumen.
Tinjauan Pustaka
Riset di bidang speaker diarization dan speaker verification modern sudah cukup matang untuk skenario tertutup (closed-set) dan batch/offline. Sistem pyannote.audio [1] mampu mencapai Diarization Error Rate rendah dengan menggabungkan segmentasi neural end-to-end dan klasterisasi embedding, sementara varian arsitektur untuk kondisi online/low-latency juga telah didokumentasikan [2] meski varian ini secara eksplisit mengorbankan sebagian akurasi demi latensi rendah. Untuk verifikasi identitas, model deep embedding seperti ECAPA-TDNN [3], yang diimplementasikan dalam toolkit SpeechBrain [4], sudah menjadi standar de-facto dan terbukti sangat akurat ketika seluruh pembicara yang mungkin muncul sudah diketahui sebelumnya. Untuk transkipsi ucapan ke teks, model Whisper [5] yang diimplementasikan secara teroptimasi untuk CPU melalui faster-whisper[6] menjadi pilihan populer karena mendukung banyak bahasa termasuk indonesia dengan kualitas yang cukup baik tanpa memerlukan pelatihan ulang.
Namun, dua tantangan utama dalam riset ini masih menjadi area yang aktif diteliti, yaitu open-set speaker verification, ketika muncul suara yang tidak terdaftar dalam database, dan kalibrasi threshold pada sistem online atau streaming. Chen et al. [7] menunjukkan bahwa embedding speaker verification konvensional, termasuk ECAPA-TDNN, lebih difokuskan untuk membedakan identitas yang sudah dikenal sehingga penggunaan satu threshold sederhana belum optimal untuk mengenali identitas baru. Selain itu, studi terkait probabilistic back-end untuk pengenalan dan klasterisasi speaker secara online [8] menunjukkan bahwa metode kalibrasi konvensional, termasuk leave-one-out, umumnya menggunakan data batch, sedangkan sistem real-time bekerja secara streaming. Perbedaan ini dapat menyebabkan threshold yang telah dikalibrasi tetap mengalami ketidaksesuaian saat diterapkan dalam praktik.
Gap / peluang: Mayoritas riset di atas dievaluasi dengan dataset besar (mis. VoxCeleb: 1000+ pembicara) dan/atau infrastruktur GPU. Belum banyak dokumentasi empiris soal bagaimana kombinasi ketiga modul ini berperilaku di kondisi realistis pengguna individu/tim kecil dengan hardware terbatas (CPU-only) dan data enrollment yang sangat minim (3–5 sampel/orang) seperti pada riset ini
Arah pendekatan kami: Riset ini mengadopsi pendekatan threshold terkalibrasi (leave-one-out) dan margin-based decision sebagai baseline praktis bukan mengklaim menyelesaikan masalah open-set secara prinsipiil seperti [7], melainkan mendokumentasikan secara jujur sejauh mana pendekatan sederhana ini dapat diandalkan pada skala kecil dan CPU terbatas, sekaligus menandai batasnya sesuai apa yang sudah diprediksi literatur di atas.
Metodologi
- Sumber & pengumpulan data: Data voiceprint dikumpulkan dari 4 individu terdaftar melalui enrollment 3–5 sampel suara per orang, direkam langsung via mikrofon laptop (menggunakan skrip perekaman kustom) atau diekstraksi dari berkas audio yang sudah ada (mis. voice note, dikonversi ke format WAV 16 kHz mono). Data uji berupa sesi percakapan langsung (bukan dataset publik), melibatkan kombinasi pembicara terdaftar dan tidak terdaftar, termasuk kondisi ucapan tumpang-tindih (overlapping speech) yang teramati secara insidental selama pengujian real-time, belum sebagai skenario data uji terstruktur.
- Praproses: Audio mikrofon ditangkap pada sample rate 16 kHz mono. Segmentasi dilakukan via sliding window. Sebelum masuk ke speech-to-text, diterapkan voice activity detection filter (vad_filter) untuk menekan transkripsi halusinasi pada segmen bernoise rendah/hening.
- Pembagian data: Riset ini tidak melibatkan pelatihan ulang model (seluruh model yang dipakai adalah model pretrained yaitu pyannote.audio, ECAPA-TDNN, Whisper), sehingga tidak ada skema train/val/test split konvensional. Validasi yang dilakukan terbatas pada kalibrasi threshold verifikasi speaker menggunakan skema leave-one-out pada level sampel per individu tiap sampel enrollment dibandingkan terhadap rata-rata sampel lain milik orang yang sama, bukan dirinya sendiri, untuk menghindari estimasi Equal Error Rate yang bias. Tidak ada held-out test set independen yang terpisah dari data enrollment, ini dicatat eksplisit sebagai limitasi.
- Model / algoritma: (1) pyannote/speaker-diarization-community-1 [1] untuk segmentasi & klasterisasi pembicara; (2) speechbrain/spkrec-ecapa-voxceleb (ECAPA-TDNN) [3], [4] untuk ekstraksi voice embedding dan verifikasi identitas, dengan mekanisme tambahan UnknownSpeakerRegistry dikembangkan mandiri yang memanfaatkan ulang embedding yang sama untuk klasterisasi pembicara tak dikenal secara persisten sepanjang sesi (Unknown_1, Unknown_2, dst., berdasarkan cosine similarity dengan threshold 0,35); (3) faster-whisper [6] (implementasi CTranslate2 dari Whisper [5]) untuk transkripsi.
- Environment & dependency: Python 3.11, Windows 11 Home Single Language (versi 25H2), laptop ASUS VivoBook M1403QA (AMD Ryzen 5 5600H 3.30 GHz, RAM 16 GB, grafis terintegrasi AMD Radeon 496 MB, tanpa GPU diskrit). Pustaka utama: pyannote.audio, speechbrain, faster-whisper, torch (versi CPU-only), sounddevice, flask.
- Parameter penting & training: Window duration 4 detik, hop duration 2 detik; threshold verifikasi ≈0,447 (dihitung otomatis per sesi via leave-one-out, bukan nilai tetap); margin minimum 0,05; threshold klaster Unknown_N 0,35 (heuristik, belum dikalibrasi statistik); durasi minimum segmen untuk verifikasi 1,0 detik dan untuk transkripsi 0,7 detik; model faster-whisper diuji pada ukuran tiny, base, small; compute_type=int8. Tidak ada proses training/fine-tuning model seluruh model dipakai dalam kondisi pretrained tanpa modifikasi bobot.
- Metrik evaluasi: Skor kemiripan cosine similarity (0–1) untuk identifikasi speaker; observasi kualitatif kebenaran nama yang dikenali dan konsistensi label Unknown_N antar-sesi; observasi kualitatif kualitas teks transkripsi; pengukuran latensi (detik) dari ucapan hingga keluaran teks. Metrik standar (Diarization Error Rate, Word Error Rate) belum diterapkan pada tahap riset ini dicatat sebagai limitasi dan arah lanjutan.
- Lokasi kode/eksperimen mentah (wajib): Seluruh kode sumber dan eksperimen mentah tersedia pada repositori GitHub: https://github.com/ai-lab-id/AI-Identifikasi-Suara Branch main
Hasil & Temuan
Integrasi pipeline ke antarmuka fungsional. Ketiga modul (diarization, verification, speech-to-text) diintegrasikan menjadi satu sistem yang dapat diakses dan dioperasikan secara langsung melalui dashboard web, sebagaimana ditunjukkan pada Gambar 1. Antarmuka ini menampilkan panel kontrol (pemilihan ukuran model speech-to-text dan parameter margin), indikator status sesi secara langsung, daftar pembicara terdaftar, serta umpan (feed) transkrip yang diperbarui secara real-time setiap kali satu segmen ucapan selesai diproses.
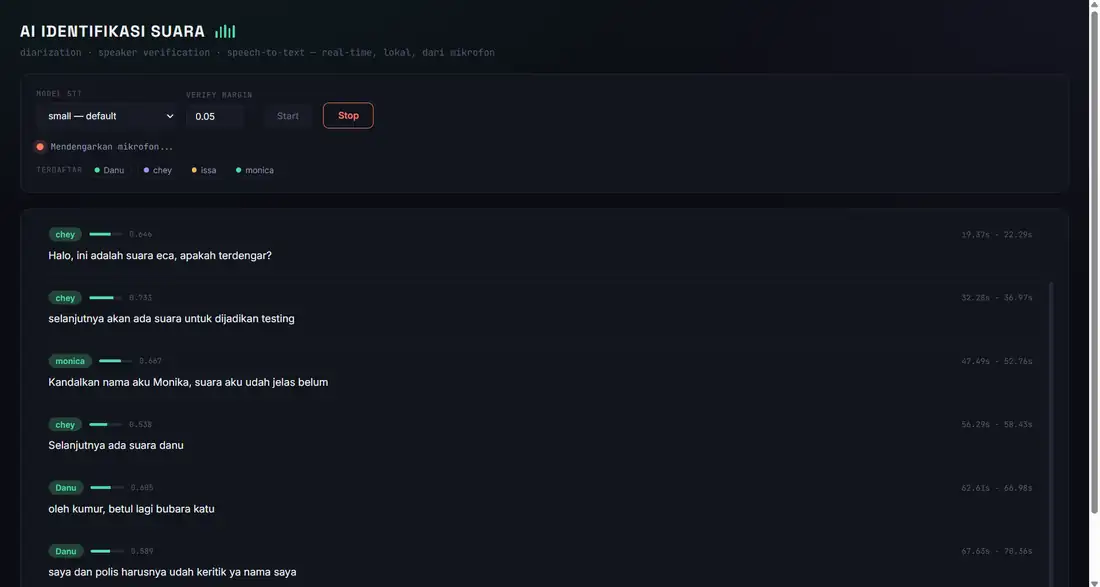
Gambar 1. Dashboard identifikasi dan transkripsi suara secara real-time beserta status mikrofon, daftar pembicara, skor kemiripan, dan hasil transkripsi.
Efektivitas mekanisme margin dalam menekan kesalahan false accept. Sebelum mekanisme margin diterapkan, ditemukan kasus pembicara tidak terdaftar yang keliru dikenali sebagai "chey" dengan skor 0,244; 0,258; dan 0,215 pada saat itu threshold yang sedang diuji ditetapkan 0,2, sehingga selisih skor terhadap threshold hanya 0,015-0,058 poin (Gambar 2), jauh di bawah margin yang dianggap aman untuk keputusan identifikasi yang meyakinkan. Pada tahap ini sistem belum mencatat skor kandidat kedua tertinggi sebagai pembanding langsung fitur ini baru ditambahkan bersamaan dengan implementasi margin, sehingga selisih skor spesifik antara kandidat pertama dan kedua pada kasus ini tidak dapat dilaporkan secara kuantitatif, namun kedekatan skor terhadap threshold yang sangat tipis (≤0,058 poin) sudah cukup mengindikasikan keputusan identifikasi yang berada pada kondisi ambang batas rentan. Setelah mekanisme margin diaktifkan, mensyaratkan selisih minimum 0,05 poin antara skor kandidat pertama dan kedua, kasus serupa pada sesi pengujian berikutnya berhasil ditolak dan dilabeli tidak dikenal alih-alih dipaksa dikenali sebagai nama terdaftar.

Gambar 2. Kasus False accept ketika pembicara tidak terdaftar teridentifikasi sebagai “chey” dengan skor kemiripan rendah.
Pelabelan pembicara tak dikenal dengan hasil sebagian berhasil, sebagian tidak konsisten. Pengujian menunjukkan UnknownSpeakerRegistry mampu mempertahankan identitas pembicara tak dikenal pada beberapa kondisi pembicara yang sama memperoleh label Unknown yang sama pada kemunculan berikutnya (Gambar 3, mis. Unknown_2 konsisten pada dua kemunculan berurutan; Unknown_3 demikian pula; pembicara "chey" dikenali dengan skor tinggi 0,831 pada ucapan yang jelas). Namun, konsistensi ini belum selalu tercapai pada kondisi akustik berbeda (perubahan durasi ucapan, intonasi, atau kualitas sinyal), pembicara yang sama terkadang diberi label Unknown baru, menunjukkan mekanisme klasterisasi masih memiliki keterbatasan pada variasi kondisi suara.
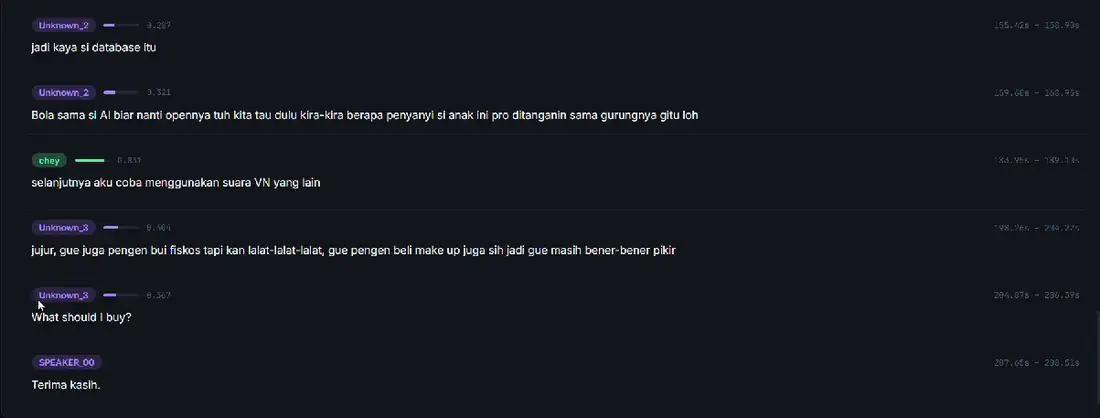
Gambar 3. Hasil identifikasi beberapa pembicara dengan label Unknown_N, chey, dan SPEAKER_00, termasuk indikasi ketidakkonsistenan pada segmen “Terima kasih.”
Pola halusinasi transkripsi pada segmen hening. Pada baris terakhir sesi yang didokumentasikan di Gambar 3, ditemukan satu segmen berlabel SPEAKER_00 tanpa identitas maupun skor kemiripan sama sekali, berisi teks "Terima kasih." Ketiadaan skor ini bukan kegagalan verifikasi, melainkan indikasi durasi segmen berada di bawah ambang batas minimum verifikasi (1,0 detik) meski masih di atas ambang batas minimum transkripsi (0,7 detik) celah kecil antara dua ambang batas durasi yang berbeda ini menghasilkan kombinasi "teks ada, identitas tidak ada". Pola ini konsisten dengan dugaan segmen tersebut sebenarnya berisi jeda napas atau derau latar yang sangat singkat, bukan ucapan sungguhan, dan diterjemahkan Whisper menjadi frasa generik akibat karakteristik data latihannya. Aktivasi vad_filter diterapkan sebagai langkah mitigasi setelah pola ini teridentifikasi.
Regresi akurasi pada migrasi ke antarmuka web dan resolusinya. Pada percobaan awal integrasi dashboard Flask, ditemukan penurunan akurasi drastis dan tak terduga seluruh pembicara terdaftar (termasuk "chey" yang berjarak dekat dari mikrofon) gagal dikenali dengan skor sangat rendah (0,074–0,212), disertai teks transkripsi yang berulang kali salah "Terima kasih" muncul pada hampir seluruh segmen. Penelusuran mengarah pada kesalahan pemilihan device audio, terkait cara thread Python menginisialisasi library audio (sounddevice/PortAudio) pada Windows penangkapan mikrofon yang berjalan pada thread non-utama (akibat lapisan tambahan background thread Flask) cenderung tidak mengakses device mikrofon fisik yang benar. Setelah diterapkan solusi pre-warming inisialisasi pustaka audio pada thread utama proses Flask sebelum thread lain dijalankan, skor identifikasi pulih ke rentang sebanding versi antarmuka terminal (0,5–0,6), mengonfirmasi akar masalah bersumber dari interaksi threading dengan perangkat keras, bukan model kecerdasan buatan itu sendiri.
| Kondisi Pengujian | Rentang Skor Kemiripan | Keterangan |
|---|---|---|
| Pembicara terdaftar (setelah kalibrasi + margin) | 0,4 - 0,8 | Kondisi dikenali benar |
| Suara asing (sebelum margin diterapkan) | 0,215 - 0,258 | False accept, berhasil ditolak setelah margin |
| Pasca-regresi Flask (sebelum fix threading audio) | 0,074-0,212 | Seluruh pembicara gagal dikenali, termasuk yang dekat dengan mikrofon |
| Pasca-perbaikan pre-warming audio | 0,5-0,6 | Pulih sebanding versi terminal |
Diskusi
Efektivitas kalibrasi threshold leave-one-out dan mekanisme margin dalam menekan kesalahan identifikasi sejalan dengan hipotesis awal riset ini, dan konsisten dengan prinsip umum di literatur speaker verification bahwa estimasi threshold yang bias, membandingkan sampel terhadap rata-rata yang memasukkan dirinya sendiri menghasilkan Equal Error Rate yang tampak sempurna namun tidak representatif di data baru, persis seperti yang ditemukan pada iterasi awal sistem ini (EER=0,00% sebelum perbaikan metode kalibrasi).
Temuan terkait inkonsistensi label Unknown_N menunjukkan bahwa masalah tersebut bukan hanya disebabkan oleh implementasi sistem, tetapi juga berkaitan dengan keterbatasan pendekatan yang telah dibahas dalam literatur. Chen et al. [7] menunjukkan bahwa embedding speaker verification seperti ECAPA-TDNN dilatih untuk membedakan identitas yang telah dikenal saat training, sehingga pendekatan threshold tunggal rentan terhadap pembicara baru (open-set). Selain itu, [8] menjelaskan bahwa kalibrasi threshold konvensional, termasuk leave-one-out, umumnya menggunakan data batch, sedangkan sistem ini bekerja secara streaming, sehingga threshold yang telah dikalibrasi tetap dapat meleset dalam praktik. Latensi dan inkonsistensi label antar-window juga sejalan dengan [2] yang menunjukkan adanya trade-off antara latensi rendah dan konsistensi klaster pada online diarization. Sementara itu, penurunan akurasi setelah migrasi ke Flask menunjukkan bahwa integrasi model AI ke web serving layer dapat menimbulkan bug dari interaksi threading dan hardware I/O audio, bukan dari model itu sendiri, sehingga menjadi salah satu engineering pitfall yang penting untuk diperhatikan dalam reproducibility penelitian serupa.
Limitasi
- Skala pengujian kecil, hanya 4 individu terdaftar, dalam 1 ruangan dan 1 perangkat mikrofon; belum diuji pada jumlah pembicara lebih banyak atau kondisi akustik lebih beragam.
- Tidak ada evaluasi kuantitatif formal, akurasi dievaluasi kualitatif dari log pengujian berulang, bukan metrik standar (DER, WER) pada dataset uji terpisah dan terlabeli independen.
- Tidak ada held-out test set, validasi threshold verifikasi terbatas pada skema leave-one-out di level sampel enrollment itu sendiri, bukan data uji yang benar-benar terpisah dari proses kalibrasi.
- Threshold klaster pembicara tak dikenal bersifat heuristik (0,35), belum dikalibrasi statistik seperti threshold verifikasi pembicara terdaftar; berdasarkan [7], pendekatan threshold tunggal untuk open-set clustering memang diketahui memiliki batas kemampuan mendasar dibanding metode khusus seperti SRPL.
- Ketergantungan infrastruktur CPU, seluruh pengujian dilakukan pada satu unit laptop kelas konsumen (AMD Ryzen 5 5600H, 16 GB RAM, tanpa GPU diskrit); temuan latensi dan trade-off ukuran model belum bisa digeneralisasi ke lingkungan dengan spesifikasi berbeda.
- Skenario tumpang-tindih suara belum diuji terstruktur, deteksi overlap baru teramati insidental, belum melalui skenario data uji yang dirancang khusus.
- Kode/eksperimen mentah belum tertaut publik pada draf ini proses pengunggahan ke repositori masih berjalan; field ini wajib dilengkapi sebelum status naik ke published.
Kesimpulan & Arah Selanjutnya
Riset ini menunjukkan sistem identifikasi suara real-time yang memadukan speaker diarization, speaker verification, dan speech-to-text dapat dibangun dan berjalan sepenuhnya lokal pada CPU standar, lengkap dengan antarmuka web, dengan kalibrasi threshold leave-one-out dan margin-based decision terbukti efektif menekan kesalahan identifikasi pembicara terdaftar. Namun, temuan negatif terkait konsistensi pelabelan pembicara tak dikenal menegaskan bahwa pendekatan berbasis threshold sederhana memiliki batas kemampuan yang sejalan dengan tantangan open-set speaker recognition yang masih menjadi area riset aktif secara umum sehingga catatan riset ini belum dapat dipromosikan ke /research/ sampai butir-butir Kesimpulan berikut ditindaklanjuti.
Arah riset selanjutnya:
- Evaluasi kuantitatif formal (DER, WER) pada dataset uji terlabeli independen, terpisah dari data kalibrasi.
- Eksplorasi pendekatan open-set yang lebih prinsipiil (mengacu [7]) sebagai perbandingan terhadap pendekatan threshold sederhana.
- Kalibrasi threshold yang mempertimbangkan konteks online/streaming (mengacu [8]), bukan sekadar leave-one-out standar.
- Pengujian skala lebih besar seperti jumlah pembicara, kondisi akustik, skenario overlapping speech terstruktur.
- Dokumentasi engineering pitfall integrasi web (isu threading audio) sebagai bagian standar reproducibility checklist untuk riset serupa ke depan.
- Melengkapi tautan repositori kode ke Metodologi sebagai syarat reproducibility.
Kepemilikan
Hak ekonomi/komersial: PT MKA (PT Mesin Kantong Ajaib)
Dokumen ini merupakan hasil kerja penulis dalam lingkup kegiatan kerja praktik (KP) di AI Lab (ai-lab.id).
Tim & Kredit
- Cheyza Amanda Syafira
- Muhammad Rizki
Changelog
- v0.1 (18 Agustus 2026): Draft awal.
Daftar pustaka
- H. Bredin, R. Yin, J. M. Coria, G. Gelly, P. Korshunov, M. Lavechin, D. Fustes, H. Titeux, W. Bouaziz, dan M.-P. Gill, "pyannote.audio: neural building blocks for speaker diarization," dalam Proc. ICASSP 2020, Barcelona, Spanyol, 2020.
- J. M. Coria, H. Bredin, S. Ghannay, dan S. Rosset, "Overlap-aware low-latency online speaker diarization based on end-to-end local segmentation," dalam Proc. ASRU 2021, Cartagena, Kolombia, 2021.
- B. Desplanques, J. Thienpondt, dan K. Demuynck, "ECAPA-TDNN: Emphasized channel attention, propagation and aggregation in TDNN based speaker verification," dalam Proc. Interspeech 2020, Shanghai, Tiongkok, 2020.
- M. Ravanelli, T. Parcollet, et al., "SpeechBrain: A general-purpose speech toolkit," arXiv preprint arXiv:2106.04624, 2021.
- A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, dan I. Sutskever, "Robust speech recognition via large-scale weak supervision," OpenAI, 2022.
- SYSTRAN, "faster-whisper: Faster Whisper transcription with CTranslate2," versi terkini, 2024. [Daring]. Tersedia: https://github.com/SYSTRAN/faster-whisper tautan
- Z. Chen, Z. Ai, X. Li, dan S. Xu, "Enhancing open-set speaker identification through rapid tuning with speaker reciprocal points and negative sample," arXiv preprint arXiv:2409.15742, 2024.
- "Probabilistic back-ends for online speaker recognition and clustering," arXiv preprint arXiv:2302.09523, 2023.
Cara mengutip
Cheyza Amanda Syafira, Muhammad Rizki (2026). AI Identifikasi Suara: Integrasi Speaker Diarization, Verification, dan Speech-to-Text secara Real-Time. .
Lisensi: Hak cipta dilindungi